Awaria Microsoft 12–13 listopada 2026: Outlook, Teams i OneDrive niedostępne przez ponad dobę

12 listopada 2026, w czwartek po południu czasu wschodnioamerykańskiego (ok. 18:30–19:00 czasu polskiego), serwisy Microsoft 365 zaczęły masowo odmawiać posłuszeństwa. Awaria trwała ponad dobę i dotknęła użytkowników w co najmniej 74 krajach.
Co przestało działać
Microsoft's Service Health page potwierdziła problemy z następującymi usługami:
- Exchange Online (Outlook) — najpoważniejszy impact, szczyt ponad 131 000 zgłoszeń na Downdetectorze
- Microsoft Teams
- SharePoint Online
- OneDrive
- Microsoft Copilot 365
- Microsoft Defender XDR
- Azure — problemy z warstwą chmurową wpłynęły na szeroki zasięg awarii
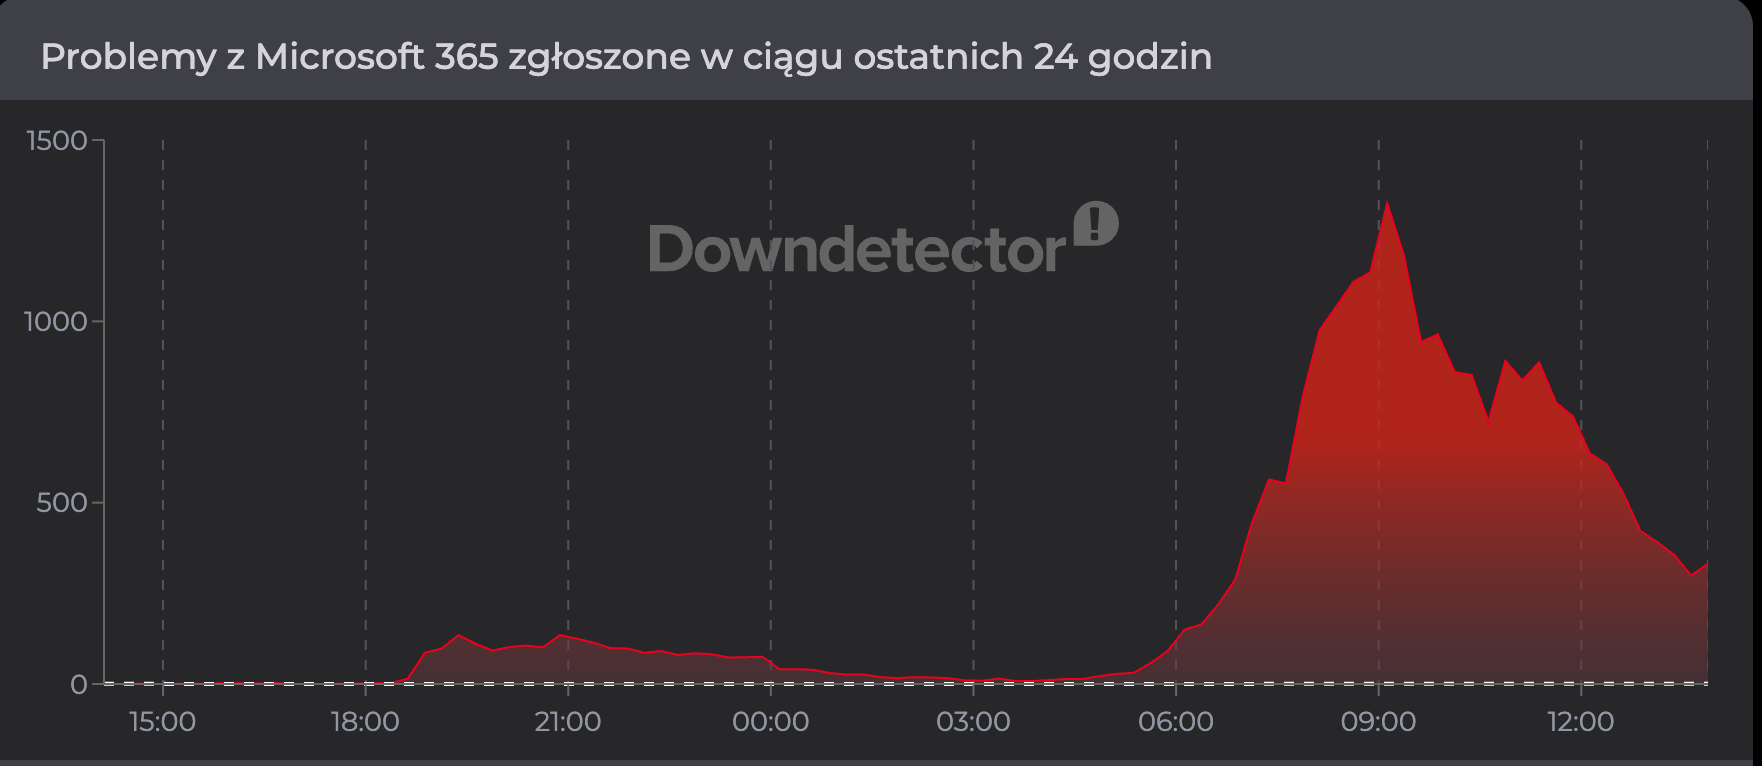
Niedostępność Outlooka odczuły m.in. instytucje publiczne. Brytyjski rząd ogłosił, że ocenia wpływ na swoje systemy, a część rad miejskich i służb policyjnych ostrzegła obywateli, że przesyłanie formularzy online może nie działać.
Oś czasu (czas polskiego — CET)
| Czas (CET) | Co się dzieje |
|---|---|
| ~18:30, 12 lis | Pierwsze masowe raporty, Downdetector rośnie gwałtownie |
| ~19:00, 12 lis | Microsoft potwierdza badanie problemu z Exchange Online w obu Amerykach |
| ~20:25, 12 lis | Chwilowe uspokojenie zgłoszeń — problemy wracają |
| ~22:00, 12 lis | Microsoft testuje zmianę konfiguracji, restartuje dotknięte serwery |
| ~23:02, 12 lis | Zwalidowana alternatywna metoda health-check, część serwerów wraca do działania |
| ~01:05, 13 lis | Szczyt Outlooka: ~131 000 zgłoszeń na Downdetectorze |
| ~03:45, 13 lis | Zgłoszenia spadają do ~40 000 |
| ~08:45, 13 lis | Microsoft: „wczesna stabilizacja i poprawa pojemności" |
| ~09:45, 13 lis | Okno timeout dla e-maili Outlook przedłużone do 48h (żeby wiadomości w kolejce nie zginęły) |
| ~13:00, 13 lis | Microsoft: „dodatkowy postęp", ale „przerywane problemy mogą się utrzymywać" |
Co było przyczyną
Microsoft wskazał na „elevated load" — część serwerów stała się niespodziewanie niedostępna, co przeniosło obciążenie na pozostałą infrastrukturę. Automatyczne health-checki przestały działać poprawnie, co uniemożliwiło systemowi samoczynne naprawienie się.
Kluczowy fragment oficjalnego komunikatu: jeden z procesów odpowiedzialnych za monitorowanie zdrowia serwerów był przeciążony, co uniemożliwiało prawidłową ocenę stanu infrastruktury i blokował automatyczne odtwarzanie.
Co istotne z perspektywy SRE:
- Microsoft nie zidentyfikował żadnej zmiany wdrożonej tuż przed awarią jako przyczyny
- Incydent bezpieczeństwa wykluczono (stan na 13 listopada)
- Jako workaround zastosowano alternatywny mechanizm health-check, który pozwolił stopniowo przywrócić serwery do pracy
Jak naprawiono
Dwa etapy:
- Zatrzymanie kaskady — wstrzymanie wszystkich deploymentów i zmian konfiguracyjnych, żeby nie pogarszać sytuacji
- Alternatywny health-check — zamiast naprawiać przeciążony komponent, Microsoft wdrożył zastępczą ścieżkę oceny zdrowia serwerów, co pozwoliło stopniowo dodawać pojemność z powrotem do puli
Klasyczne podejście: jeśli mechanizm naprawczy sam jest uszkodzony, omiń go i napraw stan systemu z zewnątrz.
Co to oznacza dla zespołów DevOps
Kilka wniosków operacyjnych z tej awarii:
Zależność od M365 jako krytycznej infrastruktury — wiele organizacji traktuje Outlook i Teams jak narzędzia biurowe, nie jak infrastrukturę. Ta awaria pokazała, że przy braku alternatywnych kanałów komunikacji (Slack, własny serwer XMPP, nawet SMS) incydenty produkcyjne mogą stać się niemożliwe do skoordynowania.
Cascading failure przez health-check — awaria nie wynikała z bezpośredniego problemu aplikacyjnego, ale z uszkodzonego mechanizmu monitorowania zdrowia. To klasyczny anti-pattern: health-check sam staje się SPOF (Single Point of Failure). Warto sprawdzić, czy wasze własne health-checki są odporne na przeciążenie.
Extended email timeouts jako mitygacja — przedłużenie okna timeout dla wiadomości do 48h to sprytna taktyka: zamiast błędu delivery failure, e-maile trafiają do kolejki i są dostarczane gdy pojemność wraca. Warto mieć podobny mechanizm dla własnych kolejek wiadomości (SQS, RabbitMQ, Kafka) przy planowaniu degraded mode.
Phishing na outage — TechRadar ostrzegał przed falą phishingowych SMS-ów i e-maili podszywających się pod Microsoft z prośbą o reset hasła. Awaria to ulubiony moment dla social-engineeringu. Warto mieć przygotowaną komunikację do użytkowników: „podczas awarii nigdy nie wysyłamy próśb o reset hasła".
Status na 13 listopada (stan artykułu)
Awaria częściowo opanowana, trwa przywracanie pełnej pojemności. Microsoft rożnosi ruch ostrożnie, żeby nie przeciążyć ponownie odtwarzanej infrastruktury. Backlog e-maili w trakcie dostarczania — użytkownicy mogą jeszcze przez kilka godzin obserwować opóźnienia w dostarczaniu poczty.
Pełnego post-mortem Microsoft jeszcze nie opublikował.
Źródła: TechRadar — live coverage, WindowsCentral, CNN live updates
Comments ()